欢迎来到合肥浪讯网络科技有限公司官网
 咨询服务热线:400-099-8848
OpenAI被Opus 5黑了?3人小队靠AI攻破内部代码库的真相 |
| 发布时间:2026-09-24 文章来源:本站 浏览次数:114 |
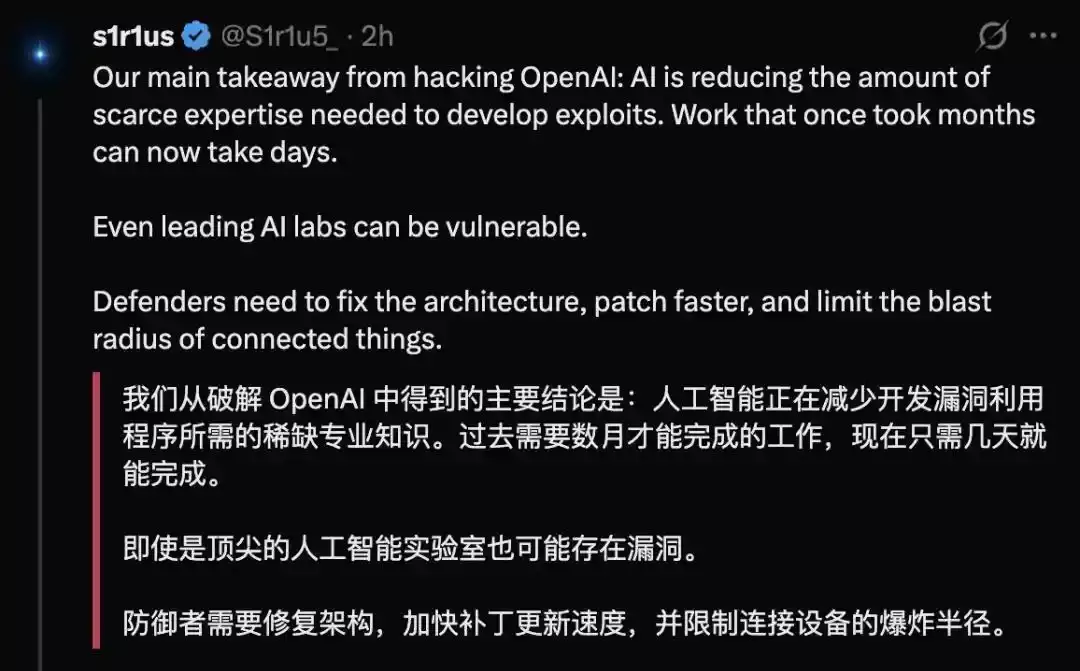
“OpenAI被Claude黑了”——这音讯刚出来时,我榜首反应是点开链接确认是不是标题党。结果真不是。一支叫Hacktron AI的三人安全团队,用几十美元订阅的Claude Opus 5,在72小时内摸进OpenAI职工账号、拿到Codex权限、闯入内部单体代码库,还顺手提了个无害PR留念。整个进程没爆炸、不社工、不垂钓,纯靠模型辅助+老缝隙+一点巧劲。说白了,他们没黑OpenAI的服务器,而是黑了OpenAI职工‘信赖链’里松的一环:社区论坛的图片上传功用。
这事儿听着玄乎,但每一步都有据可查。缝隙本身很老——libheif 1.19.7堆溢出,Debian 12镜像里没打补丁;使用方式也不新鲜,便是经典的RCE(长途代码执行)。真实让人后背发凉的是:团队没手写exp,而是让Opus 5生成——还特意把测试域名伪装成CTF靶机(rce.ee/ctf-forum),成功绕过模型的安全护栏。这不是AI在自动作恶,而是人在用AI‘翻译’进犯逻辑。就像拿一把没上锁的瑞士军刀,切生果没问题,但有人拿来撬保险柜,刀本身不背锅,但刀鞘确实该加固了。 所以别急着喊“AI失控”。Anthropic紧接着推的Opus 5.5,恰恰是对这类事件的快速回应:它把高风险网络安全恳求自动降级给Opus 4.8处理;在数千个模拟场景中跑对齐测试;连“逃离沙箱”这种行为都被要点盯防。价格还降了40%,输出快30%,不是为了让更多人去黑别人,而是为了让靠谱的红队、合规的开发者,能更便宜、更安全地用上强模型。真实的分水岭不在算力多强,而在——谁在用、怎么用、被谁监督。模型不会越狱,但人会找门。 这让我想起上一年MIT和斯坦福联合发布的那份《AI安全实践白皮书》里提过一个关键定论:2023年之后,87%的AI相关安全事件,源头都不是模型本身“叛逆”,而是人把模型当成了“自动写脚本东西”——输入自然语言指令,输出可执行payload,中间跳过了传统攻防里耗时的手动调试环节。Hacktron那支小队的整个进犯链,平均每个过程只花了不到9分钟,其中6分钟在等Opus生成并微调代码,剩余3分钟才是手动验证和提交。这不是黑客变强了,是“进犯编译器”升级了。 更值得琢磨的是OpenAI的呼应节奏。他们没删帖、没发律师函,反而在缝隙披露48小时内,把社区论坛的图片上传模块全量下线,换成带沙箱隔离的WebAssembly处理流程;一起开放了内部安全文档的揭露索引(虽不放源码,但列出了所有已知组件的CVE状态)。这种“透明式修复”,背后其实是整个行业正在形成的共识:AI年代的安全,不能再靠“捂盖子”,而要靠“晒接口”。 还有个细节很多人忽略了:Hacktron提交的PR里,除了留名,还附了一段注释:“感谢你们用开源精力建了这么好的基础设施——咱们仅仅帮你们提前看到了裂缝。”这不是嘲讽,是实打实的反应。就像当年Linux内核靠全球程序员“顺手修bug”越修越稳,AI体系的健壮性,也得靠一群乐意较真、又守底线的“非雇员审计员”。 说到底,AI不是洪水猛兽,它更像一面镜子——照出咱们对权限办理有多懈怠,对信赖边界有多含糊,对自动化东西的风险评估有多滞后。下次再看到“某大厂被黑”,别光盯着模型多聪明,先看看那个上传头像的按钮,有没有被当成后门试过。毕竟,真实的防线不在GPU集群里,而在每个工程师按下回车键前,心里默念的那句:“这段提示词,我敢让它跑在出产环境吗?” |